← 전체 프로젝트

01. 한 줄로 보는 CallGuard

CallGuard

120 다산콜센터 통화를 실시간으로 들으며 필요한 문서를 상담원 화면에 띄우고, 개인정보는 화면에 뜨기 전에 가리는 StreamRAG 시스템

기간
2026-08-20 ~ 진행 중
팀 · 역할
4명 · 백엔드·AI — ai 브랜치(초기) · server 브랜치 담당 (허브-스포크 골격·청킹·개인정보 마스킹·평가 하네스)
  • Python 3.13
  • FastAPI
  • PostgreSQL
  • Elasticsearch 9 · nori
  • KoE5 임베딩
  • Google STT
  • WebSocket
  • React
  • k3s · AWS
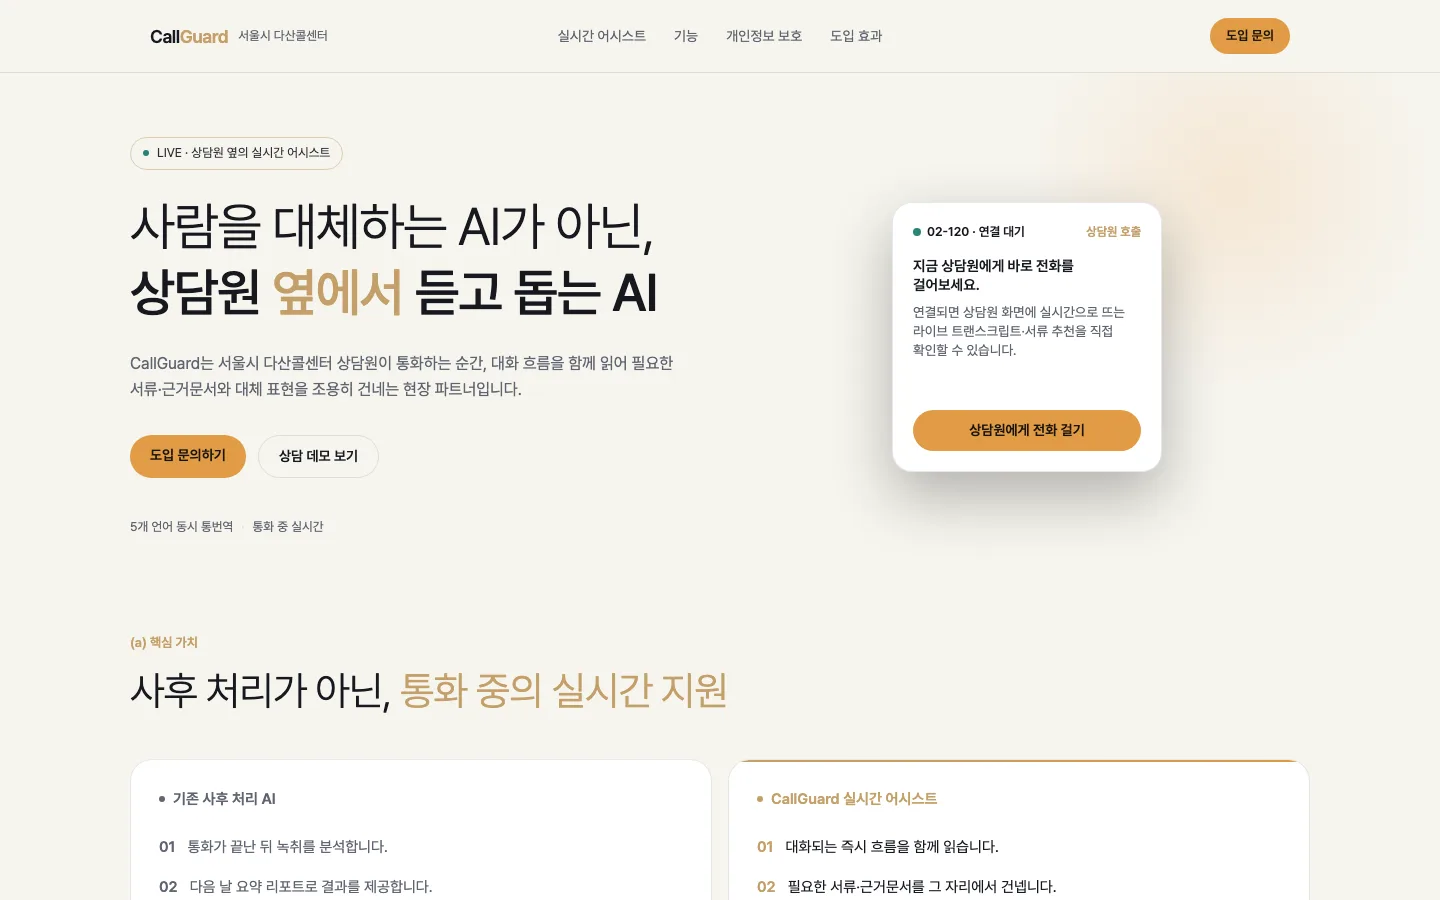
CallGuard 대표 화면

↓ 스크롤 또는 ← → 키로 넘기기

02. 설계 원칙 - server와 ai를 따로 배포할 수 있게

두 사람이 server와 ai를 나눠 개발해도 의존이 섞이지 않도록, 허브-스포크 골격과 import-linter 계약 5종을 직접 세웠습니다.
문제
요청 흐름(server)과 검색·모델(ai)을 서로 다른 팀원이 동시에 개발 — 한쪽이 다른 쪽을 import하는 순간 따로 배포할 수 없게 된다
선택
허브는 포트·DTO 계약만, 스포크는 서로 import 금지. server는 ai·torch·langchain import 금지, domain은 순수 파이썬 — 계약 5종을 CI에서 KEPT 검사
대가
스포크끼리 협력할 때마다 hub에 포트를 먼저 만들어야 해 배선 코드가 늘었다
효과
모델 없이도 규칙 채점이 CI에서 돈다. 현재 server/apps 코드의 약 75%를 작성 (git blame)
server · ai 분리와 import-linter 계약 (도식)

왜 이 선택인가 — 버린 대안

  • 레이어 규칙을 문서로만 합의
    두 사람이 동시에 코드를 쓰면 리뷰로는 잡히지 않는다 — 기계 검사로 바꿨다

허브-스포크란?

부서(스포크)끼리 직접 결재를 주고받지 못하게 하고, 공용 창구(허브)에 정해진 양식(포트)으로만 협력하게 하는 구조입니다. 덕분에 검색 부서가 모델을 통째로 바꿔도 요청 흐름 부서의 코드는 그대로입니다.

근거: server/.importlinter — 계약 5종 · docs/architecture.md

03. 개인정보 실시간 마스킹 - 애매하면 가린다

멈춰 있던 마스킹 모듈을 넘겨받아, 통화 자막이 상담원 화면에 뜨기 전에 주민번호·전화·카드·주소를 가리도록 만들었습니다.
문제
마스킹 포트 구현이 없어 자막 수신 API가 501을 돌려주고 파이프라인 전체가 막혀 있었다
선택
구분자 제거 → 한글 수사 변환(3자 이상) → 유형별 정규식·문맥 규칙. 겹치면 넓은 쪽을 남기고, 중간 자막은 3자리 이상 숫자를 전부 가림. 전화번호는 받는 즉시 HMAC 해시
대가
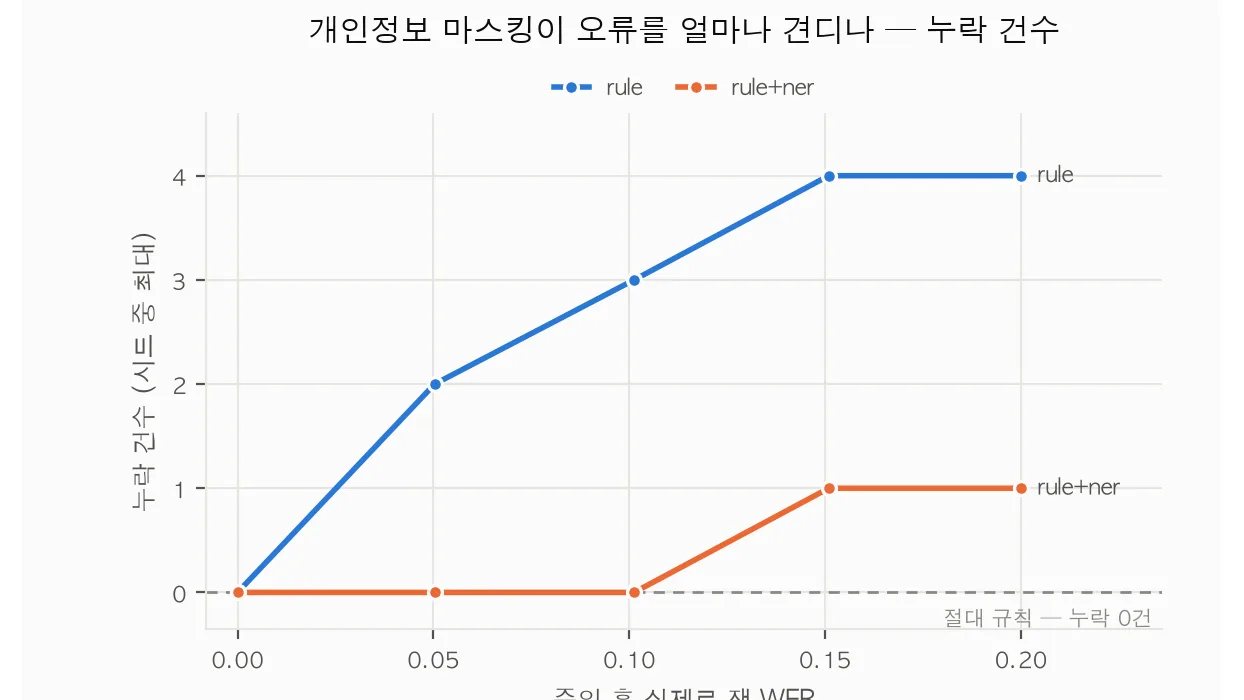
과잉 마스킹을 감수했고, 음성 인식(STT) 오류가 섞이면 누락이 생긴다
효과
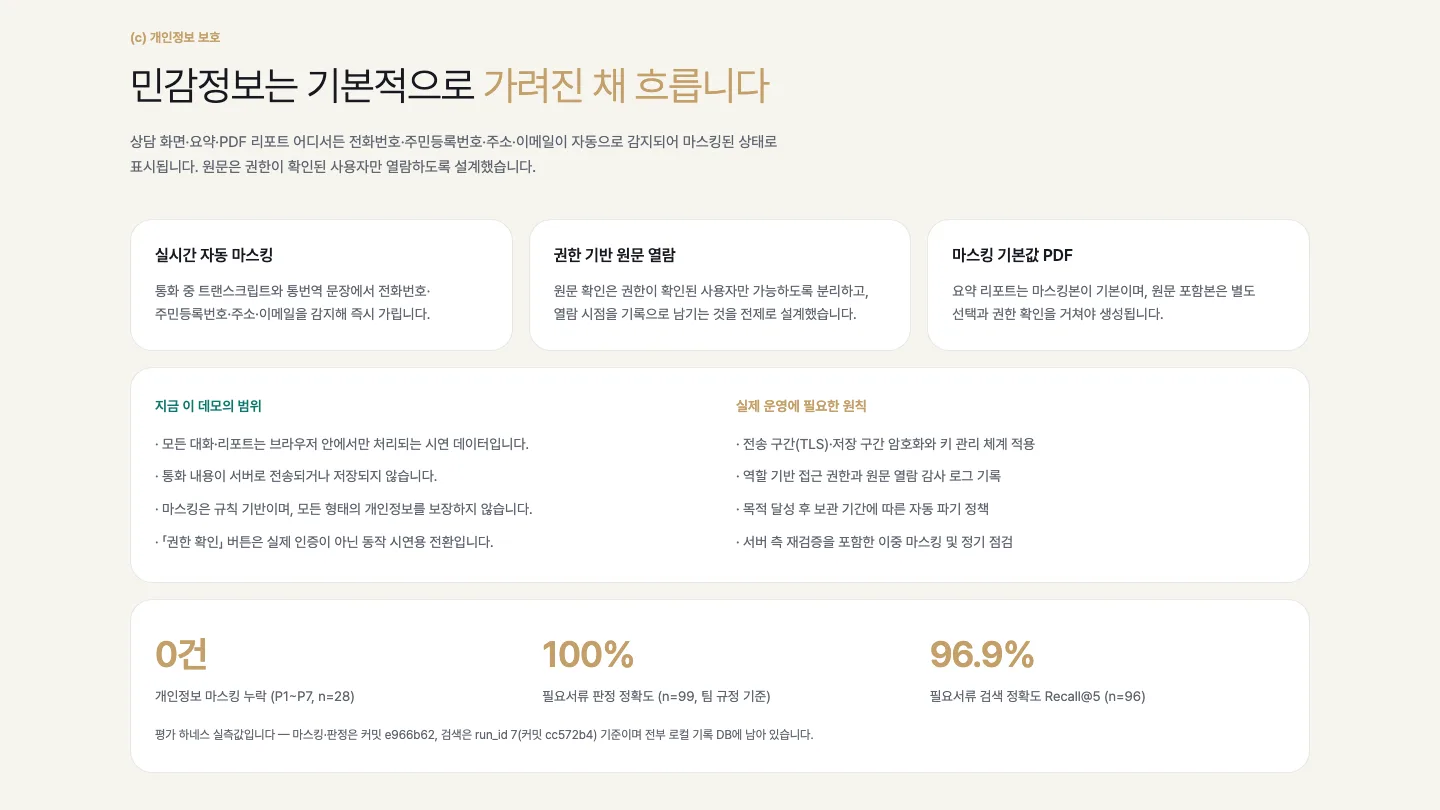
골든셋 누락 3건 → 0건. 운영 구성 누락 0건 (n=40)
민감정보는 기본적으로 가려진 채 흐른다
STT 오류율에 따른 마스킹 누락 건수

왜 이 선택인가 — 버린 대안

  • 마스킹 없이 먼저 통과
    보안 요구사항(SEC-1) 위반 — 파이프라인을 여는 것보다 가리는 것이 먼저
  • 중간 자막은 아예 보내지 않기
    상담원이 실시간으로 흐름을 볼 수 없게 된다 — 숫자만 전부 가리는 쪽을 택함

왜 "넓게" 가리나?

개인정보는 한 번 화면에 뜨면 되돌릴 수 없습니다. 그래서 놓치는 것보다 조금 더 가리는 쪽을 원칙으로 두었습니다. 대신 과잉 마스킹을 재는 음성 케이스를 따로 만들어, 얼마나 더 가리는지도 숫자로 봅니다.

근거: pii_detector.py · 결정 019 — C-5 담당 이관 · 결정 324 — 중간 자막 숫자 가림

04. StreamRAG - 말이 끝난 순간에만 찾는다

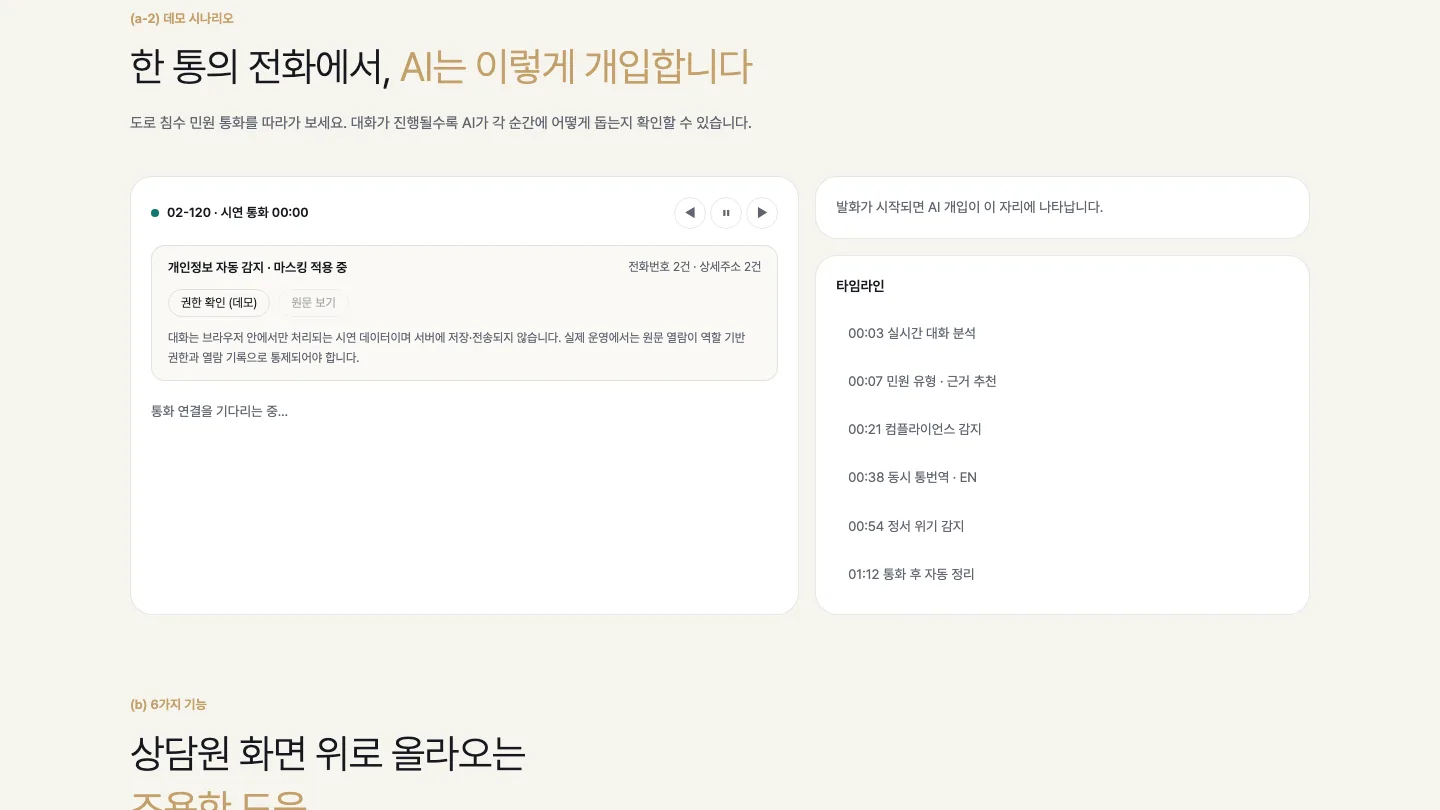
통화 중 자막은 20초에 199건씩 들어옵니다. 매번 검색하지 않고, 고객의 말이 확정된 순간에만 문서를 찾아 카드로 띄우는 흐름을 배선했습니다.
문제
중간 자막마다 검색하면 검색 서버가 과부하되고, 상담원 화면이 계속 바뀌어 읽을 수 없다
선택
STT 확정(is_final) + 고객 발화일 때만 검색을 발동. 추천 API 배선, 게이트웨이 실제 도착 시각 전달, 검색 장애 시 503, 모노 녹음 화자 분리
대가
트리거 지연은 상수로 모형화한 값이라 채점하지 않는다 — 채점하면 가짜 만점이 나온다
효과
검색이 고객 발화가 확정될 때만 한 번씩 발동해 카드가 흔들리지 않는다 (트리거 지연은 측정 전)
한 통의 전화에서 AI가 개입하는 순간들

왜 이 선택인가 — 버린 대안

  • 중간 자막마다 검색
    20초에 199번 검색 — 비용과 화면 흔들림이 모두 커진다

StreamRAG란?

보통의 RAG는 질문이 끝난 뒤 문서를 찾아 답합니다. StreamRAG는 대화가 흘러가는 도중에 "지금 찾을 때"를 스스로 판단해 문서를 찾아 둡니다. 상담원이 묻기 전에 필요한 서류가 이미 화면에 올라와 있게 하는 것이 목표입니다.

근거: docs/architecture.md

05. 검색 구성 - 측정하고 하이브리드를 뺐다

기획서는 BM25 + 벡터 + RRF 하이브리드를 최종형으로 가정했습니다. 같은 골든셋으로 나란히 재 보니 하이브리드가 벡터 단독보다 낮아, 팀은 벡터 검색을 택했습니다.
문제
Elasticsearch의 내장 RRF는 무료(basic) 라이선스에서 403 — 기획서의 최종형을 그대로 쓸 수 없었다
선택
RRF를 순수 파이썬 domain 계층에 직접 구현해 BM25 · dense · hybrid를 같은 골든셋(n=96)으로 비교. 저는 초기 ai 브랜치에서 지식베이스 조항 단위 청킹(첫 스포크)과 ES+nori 이미지를 맡음
대가
운영에 임베딩 모델 이미지와 벡터 적재가 필요해졌다
효과
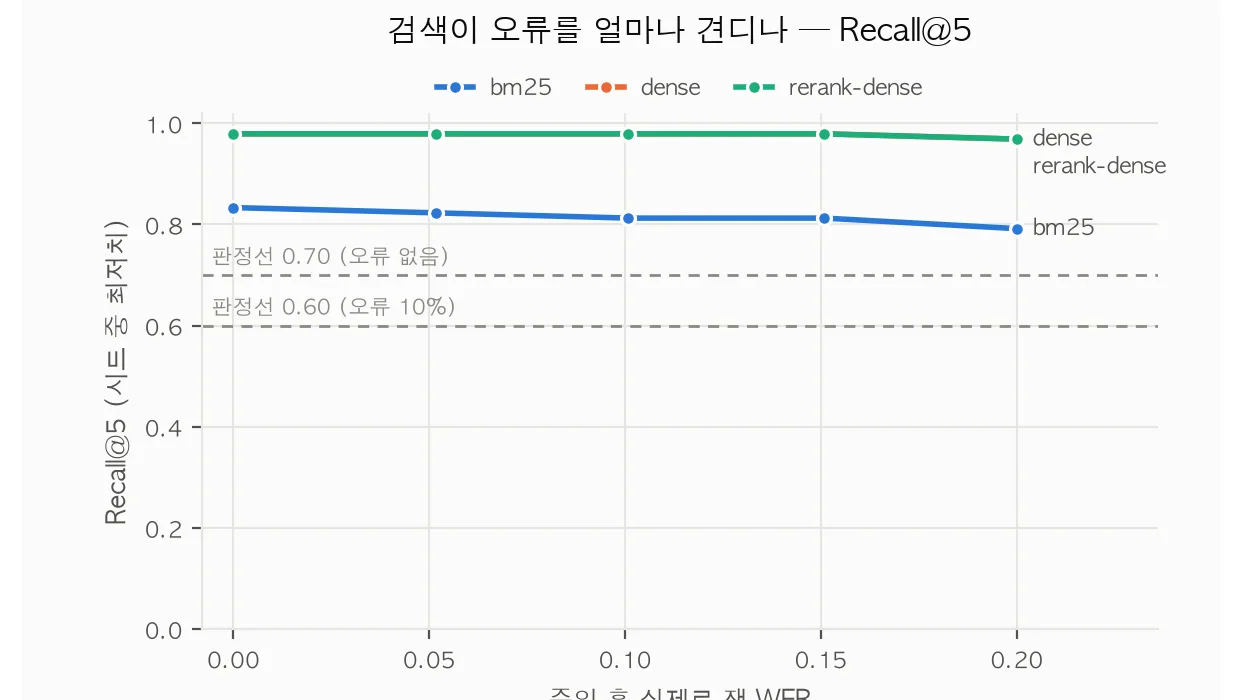
Recall@5 — BM25 0.833 · dense 0.979 · hybrid 0.927 → 하이브리드 기각. 운영 dense 0.971 (BM25 기준선 0.853)
STT 오류율에 따른 검색 Recall@5 — dense가 끝까지 버틴다

왜 이 선택인가 — 버린 대안

  • ES 유료 RRF
    라이선스 비용 — 직접 구현해도 결과는 같은 비교가 가능했다
  • 크로스 인코더 리랭크
    MRR 0.885 → 0.919로 올랐지만 p95가 59ms → 521ms — 실시간 상담에는 너무 느려 운영에서 제외

BM25 · dense · 하이브리드

BM25는 단어가 겹치는 정도로, dense는 문장의 뜻을 숫자 벡터로 바꿔 가까운 것을 찾습니다. 하이브리드는 두 순위를 합칩니다. 이 도메인에서는 합치자 BM25의 오답이 섞여 오히려 떨어졌고, 그 결과를 숫자로 확인한 뒤 뺐습니다.

근거: 결정 206 — 검색 구성 · RRF 비채택 · fusion.py — RRF 직접 구현

06. 평가 하네스 - 측정 불가를 숫자로

구현은 끝났는데 하네스는 "측정 불가"만 보고했고, 수치는 터미널에서 사라졌습니다. 하네스를 배선하고 측정값을 DB에 남겨 어떤 수치든 재현할 수 있게 했습니다.
문제
모듈이 다 있는데도 통합 측정이 한 번도 돌지 않았고, 결과가 남지 않아 비교할 수 없었다
선택
마스킹 · 판정 모듈을 하네스에 배선(프로젝트 첫 통합 측정), eval_run/eval_result 기록 — 3회 중 최저치만, NaN · 미구현은 기록 안 함. 과잉 마스킹 음성 케이스와 골든셋 v1-50 작성
대가
골든셋 대부분이 팀이 직접 쓴 문장이라 실제 통화 분포와 다를 수 있다
효과
이후 모든 수치가 run_id · 커밋 · 표본 수와 함께 남는다 (운영 Recall@5 0.971 · 누락 0건)
골든셋 → 하네스 → 기록 (도식)
골든셋 → 하네스 → 기록 (도식)

왜 이 선택인가 — 버린 대안

  • 게이트를 곧바로 CI에 켜기
    미구현 모듈 때문에 항상 빨간불 — 기록부터 쌓고 게이트는 보류

왜 "최저치"를 기록하나?

같은 측정을 여러 번 하면 운 좋게 잘 나온 값을 고르고 싶어집니다. 3번 중 가장 낮은 값을 남기면, 적힌 숫자는 적어도 그만큼은 나온다는 약속이 됩니다.

근거: _project/STATE.md — 실측 기록

07. 결과와 회고

운영 검색 Recall@5
0.971 (BM25 0.853)
운영 검색 MRR
0.875
개인정보 누락 (운영 구성)
0건 (n=40)
테스트
server 1,257 · ai 496
본인 커밋
114개 (server/apps 코드 약 75%)
AWS 배포 런북
21단계 최초 작성

아쉬운 점 · 다음에 할 것

  • 리랭크는 품질을 올렸지만 CPU에서 9배 느려 운영에서 뺐다 — GPU 예산이 있었다면 다시 볼 지점
  • 골든셋 대부분이 팀이 쓴 문장 — 실제 통화 표본으로 다시 검증해야 한다
  • 과잉 마스킹과 STT 오류 시 누락은 규칙 기반의 한계 — 모델 기반 탐지를 같은 하네스로 비교할 차례